벡터 데이터베이스 - 어려워도 하나씩
“한빛미디어 서평단 <나는리뷰어다> 활동을 위해서 책을 협찬 받아 작성된 서평입니다.”
목차
- 왜 이 책을 집어 들었나 - 벡터 데이터베이스라는 말은 자주 들었다
- 9장 한눈에 보기 - 이 책이 실제로 다루는 범위
- 2장 임베딩 - 코사인 유사도 앞에서 멈췄다
- 실전 예제가 있어서 끝까지 갈 수 있었다
- 이런 분께 추천합니다
- 이런 분께는 권하지 않습니다
- 정리 - 다음엔 기초부터 다시 보고 싶다
왜 이 책을 집어 들었나 - 벡터 데이터베이스라는 말은 자주 들었다
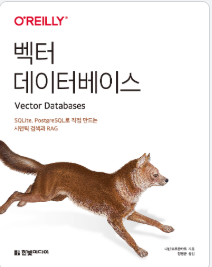
일하면서 데이터를 다루다 보니, 최근 몇 년 사이 임베딩이니 RAG니 하는 말을 여기저기서 계속 듣게 됐다. 검색이 예전처럼 단어를 정확히 맞추는 방식이 아니라, ‘의미가 비슷한 것’을 찾아주는 쪽으로 넘어가고 있다는 것도 감으로는 알고 있었다.
그런데 정작 그게 안에서 어떻게 동작하는지는 설명하기 어려웠다. 임베딩이 뭔지, 유사도를 어떻게 계산하는지, RAG가 왜 그냥 LLM 호출이 아닌지 물어보면 말이 막혔다.
한빛미디어의 벡터 데이터베이스를 고른 이유가 그거였다. 개념만 훑는 책이 아니라 FAISS, SQLite3, pgvector, Ollama 같은 도구로 직접 구현하면서 익히는 구성이라 손이 갔다.
9장 한눈에 보기 - 이 책이 실제로 다루는 범위
368쪽, 9개 장으로 구성되어 있다. 주제별로 묶으면 이렇게 정리된다.
| 구분 | 장 | 다루는 것 |
|---|---|---|
| 기초 개념 | 1~2장 | 벡터 데이터베이스가 필요한 이유 / 임베딩과 코사인 유사도 |
| 검색 엔진 구현 | 3~4장 | FAISS 인덱스와 ANN / SQLite3 확장으로 의미 기반 검색 |
| 실전 프로젝트 | 5~8장 | pgvector로 arXiv 논문 검색 / SQLite VSS·Ollama RAG / pgvector 과학 논문 RAG / 대화 기록 RAG |
| 표준화 | 9장 | 벤더에 종속되지 않는 벡터 쿼리 언어(VQL) |
앞의 두 장에서 개념을 잡고, 그다음부터는 실습 프로젝트를 하나씩 완성해 가는 구성이다. 책 소개에도 나와 있듯, 이 책을 제대로 따라가려면 파이썬과 SQL에 어느 정도 익숙해야 하고, 간단한 수학 개념도 이해할 수 있어야 한다.
2장 임베딩 - 코사인 유사도 앞에서 멈췄다
가장 오래 붙잡고 있었던 장은 2장 임베딩이었다.
Word2Vec과 Doc2Vec으로 시작해서 단어와 문서가 어떻게 벡터로 바뀌는지, 그 벡터 사이의 거리를 어떻게 재는지를 다룬다. 여기서 코사인 유사도가 나온다.
말로는 ‘의미가 비슷하면 벡터도 가깝다’는 게 이해가 됐다. 그런데 그걸 각도와 내적으로 계산하는 수식 앞에서는 속도가 확 느려졌다. 개발 일을 하면서도 이런 수학을 실제로 다시 들여다볼 일은 많지 않았다는 걸 새삼 느꼈다.
실전 예제가 있어서 끝까지 갈 수 있었다
수식에서 막혀도 책을 놓지 않을 수 있었던 이유는 따로 있다. 각 장마다 실제로 돌려볼 수 있는 예제가 바로 이어졌기 때문이다.
3장에서 FAISS로 유사도 검색을 해보고, 4장에서 SQLite3에 벡터 검색 기능을 붙여본다. 5장부터는 pgvector로 arXiv 논문 검색 시스템을, 6~7장에서는 SQLite VSS와 pgvector 각각으로 RAG 시스템을 완성하고, 8장에서는 대화 기록까지 검색하는 RAG로 마무리한다.
개념을 완전히 이해하지 못해도 코드를 따라 치고 결과를 눈으로 확인하면서 감을 잡을 수 있었다. 수식은 못 따라가도 실습은 따라갈 수 있는 구성이라는 게 이 책의 진짜 장점이라고 생각한다.
이런 분께 추천합니다
SQL에는 익숙한데 벡터 검색은 처음인 개발자
기존 관계형 데이터베이스는 다뤄봤지만 임베딩이나 유사도 검색은 이름만 들어본 경우. SQLite3, PostgreSQL처럼 익숙한 도구에 벡터 기능을 붙여보는 실습이라 낯선 인프라부터 새로 배우지 않아도 된다.
FAISS·pgvector·Ollama가 뭔지 헷갈리는 사람
이름은 여러 번 들어봤는데 서로 뭐가 다른지 설명하기 어려웠다면, 다섯 개의 실습 프로젝트를 거치면서 각 도구가 어느 지점에서 쓰이는지 비교하며 정리할 수 있다.
이런 분께는 권하지 않습니다
- 수학과는 아예 거리를 두고 싶은 분 — 2장에서 코사인 유사도 같은 개념을 수식으로 다룬다. 여기를 완전히 건너뛰면 뒤로 갈수록 이해가 흐릿해진다.
- 파이썬과 SQL이 둘 다 낯선 분 — 책이 이 둘은 다룰 줄 안다고 전제하고 넘어간다.
정리 - 다음엔 기초부터 다시 보고 싶다
벡터 데이터베이스를 덮고 나서 든 생각은 ‘이해했다’보다는 ‘더 알아야겠다’에 가까웠다.
실습을 따라가며 벡터 검색이 실제로 작동하는 흐름은 눈에 들어왔지만, 그 밑에 깔린 수학은 여전히 낯설다. 다음에는 이 책보다 한 단계 앞선, 벡터와 유사도의 기초부터 다루는 자료를 찾아 더 공부해볼 생각이다.
피드백은 언제나 환영입니다.